Pegas un número de pieza en un modelo de IA para comprobar que sigue activo antes de especificarlo en un proyecto. La respuesta llega rápido y suena segura. La das por buena, porque comprobarlo bien implica entrar al portal de un distribuidor o llamar al representante del proveedor, y te quedan cuatro más antes del almuerzo.
Esa seguridad es el problema. Un modelo de propósito general no sabe cuándo está adivinando, así que una respuesta incorrecta y una correcta llegan con el mismo tono. El Índice de Precisión de IA Industrial 2026 mide con qué frecuencia esa adivinanza falla en el tipo de preguntas que hacen ingenieros, compradores y equipos de soporte: qué es compatible, qué la reemplaza, si sigue existiendo. Si tu equipo está por poner la IA frente a esas preguntas, aquí ves con qué frecuencia se equivocará, por tipo de consulta y por marca, antes de que lo descubra un cliente.
¿Quieres ver los resultados primero? El informe completo tiene las 100 preguntas, los resultados por marca y tipo de consulta, y el método completo.
Obtener el informe completoQué evaluamos
Los FDE de ReshapeX escribieron 100 preguntas a partir de 14 catálogos de fabricantes: ATI, Banner, Beckhoff, Datalogic, Festo, Fortress, item, Misumi, Rittal, Siemens, TE Connectivity, The Imaging Source, Turck y Yaskawa. Enviamos cada pregunta 3 veces a GPT-6 Astra y a Claude a través de sus API, tanto sin herramientas como con búsqueda web, y a Gemini sin herramientas, para un total de 1500 llamadas el 24 de septiembre de 2026. Los FDE revisaron cada veredicto contra las respuestas de referencia y sus datos clave. Esas respuestas de referencia son de ReshapeX, verificadas por FDE contra la documentación del fabricante, y fueron correctas en las 100 preguntas.
Hallazgo 1: la búsqueda ayuda mucho, y la mejor puntuación aun así fue 52,0%
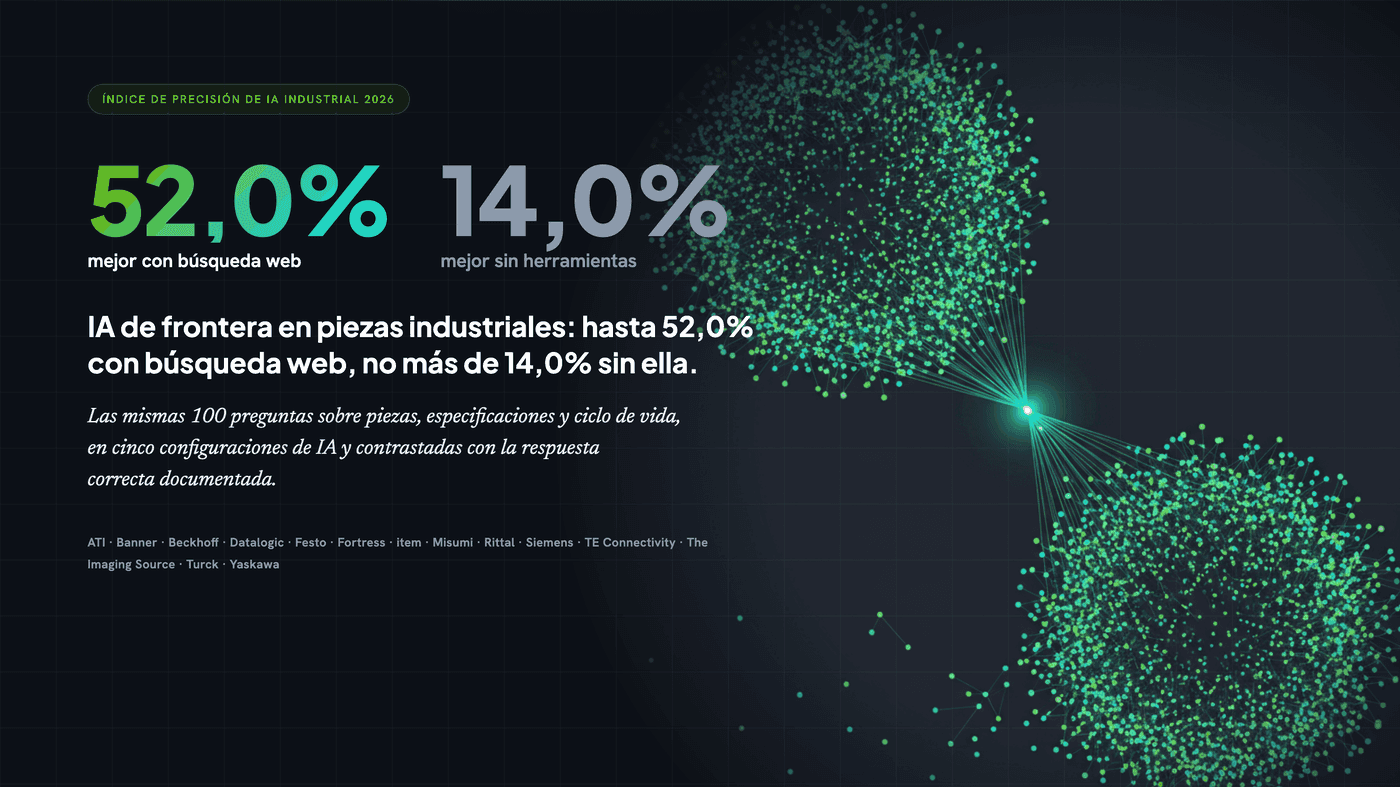
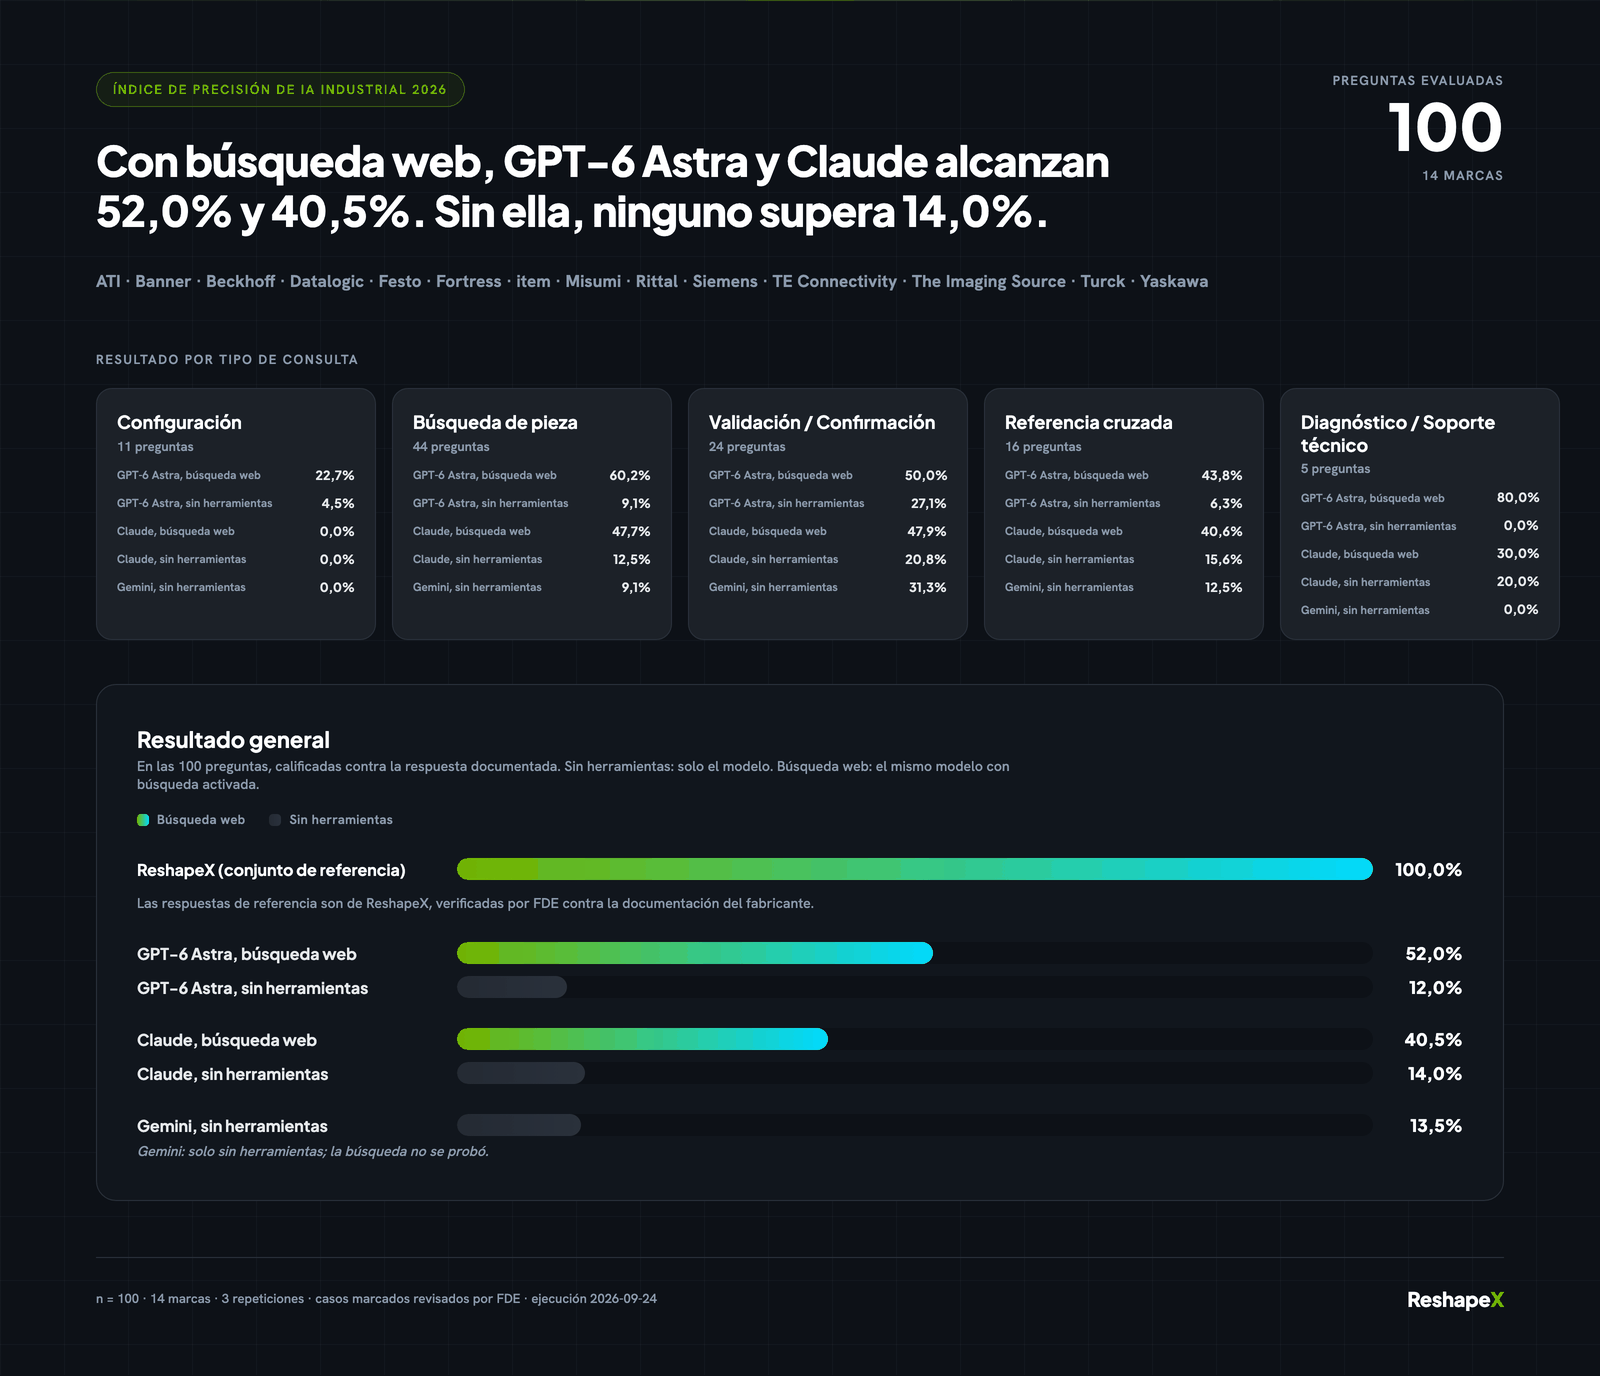
Sin herramientas, los 3 modelos obtuvieron entre 12,0% y 14,0%, cerca de 1 de cada 8. Con la búsqueda web activada, GPT-6 Astra llegó a 52,0% y Claude a 40,5%, entre 3 y 4 veces sus puntuaciones sin herramientas. Todas las configuraciones con búsqueda superaron a todas las configuraciones sin herramientas.
Donde más ayudó la búsqueda, con una muestra grande, fue en la búsqueda de piezas: un número de pieza suele estar publicado en una página indexada, y un modelo sin herramientas casi nunca lo recuerda. Aun así, la mejor configuración del estudio respondió mal 42 preguntas. La búsqueda encuentra páginas. No comprueba si la página está vigente ni si describe el producto correcto.
La puntuación cuenta una respuesta Correcta como una unidad y una Parcial como media. En el conteo estricto, sin crédito parcial, GPT-6 Astra con búsqueda respondió del todo bien 46 de 100.
Hallazgo 2: haz la misma pregunta 3 veces y obtén respuestas distintas
Cada pregunta se envió 3 veces a cada configuración. En 66 de 500 combinaciones de pregunta y configuración (13,2%), las repeticiones recibieron veredictos distintos (los veredictos por ejecución vienen del borrador del modelo; los FDE hicieron una segunda revisión de cada combinación marcada). Claude con búsqueda cambió de veredicto con más frecuencia, en 21 de 100 preguntas. GPT-6 Astra con búsqueda cambió menos, en 9 de 100. Activar la búsqueda también hizo a Claude menos estable: sin herramientas, cambió en 10 de 100.
Así que una sola prueba puntual demuestra poco. En 21 de 100 preguntas, Claude con búsqueda obtuvo un veredicto distinto según el intento que miraras.
Hallazgo 3: una respuesta incorrecta se ve igual que una correcta
Cerca de 1 de cada 3 respuestas incorrectas afirmó un dato, cifra o código concreto sin salvedad, negativa ni pregunta de aclaración: un estimado de 127 de 349 (36,5%), con un rango de 103 a 146. Esa estimación sale de una primera pasada basada en reglas, comprobada con una revisión basada en modelo de una muestra estratificada, no de una lectura humana de cada respuesta. Por separado, las notas revisadas por FDE describen al menos 13 de las 349 respuestas incorrectas como inventadas, un mínimo y no un conteo completo.
Las respuestas incorrectas no se delataron. En los casos de veredicto cambiante que aparecen más abajo, ejecuciones que se contradicen (2 números de pedido distintos, o un SKU exacto y un rotundo "no existe") llegaron con la misma seguridad. Como mucho una puede ser correcta, y nada en la redacción dice cuál. Así se ve una alucinación con piezas industriales. Un modelo al que le falta un dato tiende a producir uno plausible, y un número de pieza plausible que no existe parece real hasta que alguien lo pide. El Índice lo califica de forma directa: un código, cifra o afirmación de catálogo inventados hacen que toda la respuesta sea Incorrecta, aunque el resto sea exacto. El desglose completo de fallos, con ejemplos comentados, está en el informe.
Donde más falla: la configuración
Con la búsqueda activada, Configuración fue el tipo de consulta con la puntuación más baja: GPT-6 Astra 22,7%, Claude 0,0%. Estas preguntas describen un producto configurado, como una placa de interfaz para un robot concreto, y piden el número de pieza exacto. Ese número de pieza suele generarlo un configurador o construirse con las reglas de pedido de un catálogo, no está impreso en una página, así que la búsqueda tiene poco que recuperar. La salvedad va justo aquí: ATI aporta todas menos una de las 11 preguntas de Configuración, así que este resultado es sobre todo una puntuación sobre un solo catálogo.
En el otro extremo, GPT-6 Astra con búsqueda tuvo su mejor resultado en Diagnóstico / Soporte técnico, con 80,0%, pero ese tipo tiene solo 5 preguntas y una sola respuesta mueve mucho la puntuación. Para GPT-6 Astra, los otros 3 tipos quedan en medio; Claude tuvo su mejor resultado en Validación / Confirmación, apenas por delante de Búsqueda de pieza. El informe desglosa cada tipo y cada marca.
Dónde encaja ReshapeX
ReshapeX es una capa de grounding de conocimiento para la IA desplegada en la industria. (Explicamos por qué un modelo inventa números de pieza en Las alucinaciones no son un bug.) Para cada fabricante, el Knowledge Construction System (KCS) construye un grafo de conocimiento a partir de los catálogos y la documentación del propio fabricante: números de pieza, reglas de pedido, compatibilidad, estado de ciclo de vida, sustitutos aprobados. Un arnés de herramientas hecho a medida permite al modelo consultar ese grafo para obtener un dato verificado, en lugar de recordarlo de sus datos de entrenamiento o leerlo de una página web. En producción, los evals revisan cada respuesta antes de que la vea un cliente, y la sincronización continua mantiene el grafo al día a medida que el fabricante cambia sus líneas. Explicamos el diseño en El harness es la arquitectura y en Why AI Gets Industrial Product Questions Wrong (en inglés).
Las respuestas de ReshapeX, verificadas por FDE contra la documentación del fabricante, fueron correctas en las 100 preguntas y forman el conjunto de referencia. Eso significa que ReshapeX no se calificó junto a los demás sistemas en igualdad de condiciones. Sus respuestas verificadas definieron qué es correcto, y ninguna configuración evaluada llegó a esos datos clave verificados más del 52,0% de las veces. Esas respuestas provinieron de ReshapeX funcionando con versiones de GPT y Claude anteriores a las evaluadas. Creemos que el grounding explica la diferencia. El estudio no se diseñó para probarlo, y no mide con qué frecuencia aciertan las respuestas de ReshapeX sin revisar.
Antes de citar cualquiera de estos datos, conoce sus límites. Las respuestas de ReshapeX se recopilaron marca por marca entre el 1 de junio y el 24 de septiembre de 2026. Un modelo redactó un veredicto sugerido para cada combinación, y un FDE tomó la decisión final en las 500, corrigiendo el borrador en 33. Los FDE escribieron las preguntas y asignaron cada veredicto, sin revisión de terceros. 17 preguntas se hicieron en español, todas de Misumi e item, así que no se pueden separar idioma y catálogo. Gemini se evaluó solo sin herramientas, porque los términos de su proveedor exigen permiso por escrito para hacer benchmarks con cualquier forma de grounding, incluida la búsqueda. El informe enumera todas las limitaciones.
2 respuestas que se contradicen
El informe no publica los veredictos por ejecución para mantener privada la clave de respuestas. En ambos casos las ejecuciones se contradicen, así que no pueden ser todas correctas. Las preguntas y respuestas se citan en el idioma original (inglés).
- Beckhoff, BEC-04, Claude sin herramientas. La pregunta: "Within the CX7000 series (Arm Cortex embedded PCs with integrated I/Os), which single model has an on-board CANopen commander (master) interface? Give the order number." La ejecución 1 respondió CX7053. La ejecución 3 respondió CX7051. Las 3 ejecuciones dieron 3 números de pedido distintos.
- Rittal, RITTAL-11, Gemini sin herramientas. La pregunta: "I need a KX terminal box in 304 stainless, 200 wide, 200 tall, 80 deep. What’s the SKU?" La ejecución 1 dio un SKU exacto: "KX 1568.000". La ejecución 2 dijo: "Rittal does not make a 200 × 200 × 80 mm terminal box in the KX stainless steel range."
El método, en breve
Cada llamada fue de un solo turno, sin historial ni memoria de cuenta, con ID de modelo fijados (gpt-6-astra, claude-fable-5-1, gemini-3.8-flash) y el esfuerzo de razonamiento predeterminado de cada API. Las preguntas cubren 5 tipos de consulta: Búsqueda de pieza (44), Validación / Confirmación (24), Referencia cruzada (16), Configuración (11) y Diagnóstico / Soporte técnico (5). Una respuesta es Correcta cuando coincide con los datos clave de la respuesta de referencia, con cualquier redacción y en cualquier idioma. Doce reglas de calificación afinan ese criterio. Los FDE sometieron 157 de 500 combinaciones a una segunda revisión más a fondo. La clave de respuestas no se publica, para que las preguntas sigan sirviendo como prueba, y el informe imprime una huella digital SHA-256 del conjunto de preguntas. El método completo y las limitaciones están en el informe. Prensa, revisores y proveedores de modelos pueden solicitar la clave de respuestas a James Sugrue (james@reshapeautomation.com), y cualquiera puede volver a ejecutar las preguntas y enviarnos lo que encuentre. Si una nueva ejecución muestra un error en nuestra calificación, lo corregiremos en la próxima versión.
Descarga el informe completo: las 100 preguntas, los resultados por marca y tipo de consulta, el análisis de fallos y el método completo.
Obtener el informe completo¿Quieres ver cómo responde tu propio catálogo? Danos tus 20 preguntas más difíciles y las ejecutaremos sobre tus SKU, citando cada respuesta. Agenda una llamada de descubrimiento.