El primer artículo de esta serie hizo una sola afirmación: el arnés es la arquitectura. La orquestación, los mecanismos de respaldo, el enrutamiento de herramientas, todo lo que los equipos solían ajustar a mano en los prompts, se convirtió en una estructura confiable. El razonamiento se volvió duradero. El conocimiento sobre el que operaba ese razonamiento no. Si le hacías a un agente la misma pregunta de especificaciones dos veces, podías obtener dos respuestas distintas, según qué fragmentos trajera el recuperador y qué terminara en la ventana de contexto. Se contradecía en dos turnos de la misma conversación. Nada fallaba. Todas las verificaciones estaban en verde. La respuesta simplemente no era la misma dos veces, y nadie podía señalar por qué.
De esa brecha trata este artículo. Esas relaciones nunca se almacenaron: este motor necesita esa válvula; esta pieza reemplaza a la descontinuada; esta especificación salió de esa tabla de un PDF. Se volvían a derivar en el momento de la inferencia, de forma implícita, aproximada y rara vez idéntica de una ejecución a otra.
01 · LA BRECHA
Donde el arnés todavía se quedaba corto
El arnés resolvió la orquestación. El conocimiento en sí siguió siendo opaco: fragmentos vectoriales sin entidades, sin relaciones, sin linaje.
La recuperación encuentra texto que parece relevante, no hechos que sean verdaderos.
Ese recorrido es el producto. Un almacén de fragmentos no puede hacerlo, por buenos que sean los embeddings, porque las relaciones nunca se almacenaron. Se vuelven a inferir en cada consulta, a partir del texto que el recuperador haya encontrado.
Pero la marca ya tiene una API, ¿por qué no llamarla?
A veces, sí. Para una marca con una API buena y estable, el grafo no debe copiar el catálogo. Registra cómo usar la API: qué ruta responde qué pregunta, qué enviar, cómo leer la respuesta y qué hacer cuando no devuelve nada. En la Marca H, una marca respaldada por API, comparamos ambos enfoques directamente. Resolver frases de compradores a categorías mediante la API en vivo acertó las 17. Una copia almacenada del árbol de categorías acertó 13 y falló 4, y solo se desviará más a medida que cambie el catálogo.
Una API devuelve registros; el grafo devuelve relaciones.
Para todo lo demás, una API te da registros y no relaciones. La mayoría de las marcas reparten su conocimiento real entre una API de catálogo, una API de especificaciones, fichas técnicas en PDF, datos de referencias cruzadas y reglas que tienen los propios expertos de la marca. Ningún endpoint por sí solo devuelve "este motor requiere este variador, que funciona con estos controladores, y este está descontinuado, así que aquí está su reemplazo". El grafo materializa esas relaciones una vez, para que el agente las recorra en lugar de volver a inferirlas en cada solicitud.
El conocimiento de una marca tampoco se detiene en sus propias fronteras. Parte de lo que necesita un cliente está en la competencia, y parte está en fuentes que la marca nunca consideró propias. Ninguna API cubre eso, por buena que sea. El grafo sí, porque se construye desde donde realmente está el conocimiento. Todo lo que incorpora se almacena como parte del grafo de esta marca, limitado a esta marca, y lleva un registro de su origen. Una pieza de un competidor, por ejemplo, se convierte en un nodo propio de esta marca, nunca de otra.
Un grafo, muchas fuentes, bajo una sola herramienta. El conocimiento real de una marca nunca está en un solo lugar. KCS lo integra todo en un grafo con una sola forma: registros de API, hechos declarados, documentos y otras fuentes, normalizados en las mismas entidades y relaciones, cada uno con su propio linaje: de dónde vino, si fue declarado o inferido y qué tan seguros estamos. El agente no aprende cinco APIs ni concilia cinco flujos de autenticación y cinco esquemas. Para el conocimiento del catálogo de la marca consulta una herramienta sobre un grafo, y cada hecho responde de la misma manera, con su linaje adjunto. Las consultas en tiempo real que no son de catálogo, un contacto, una búsqueda web en vivo, siguen siendo herramientas separadas.
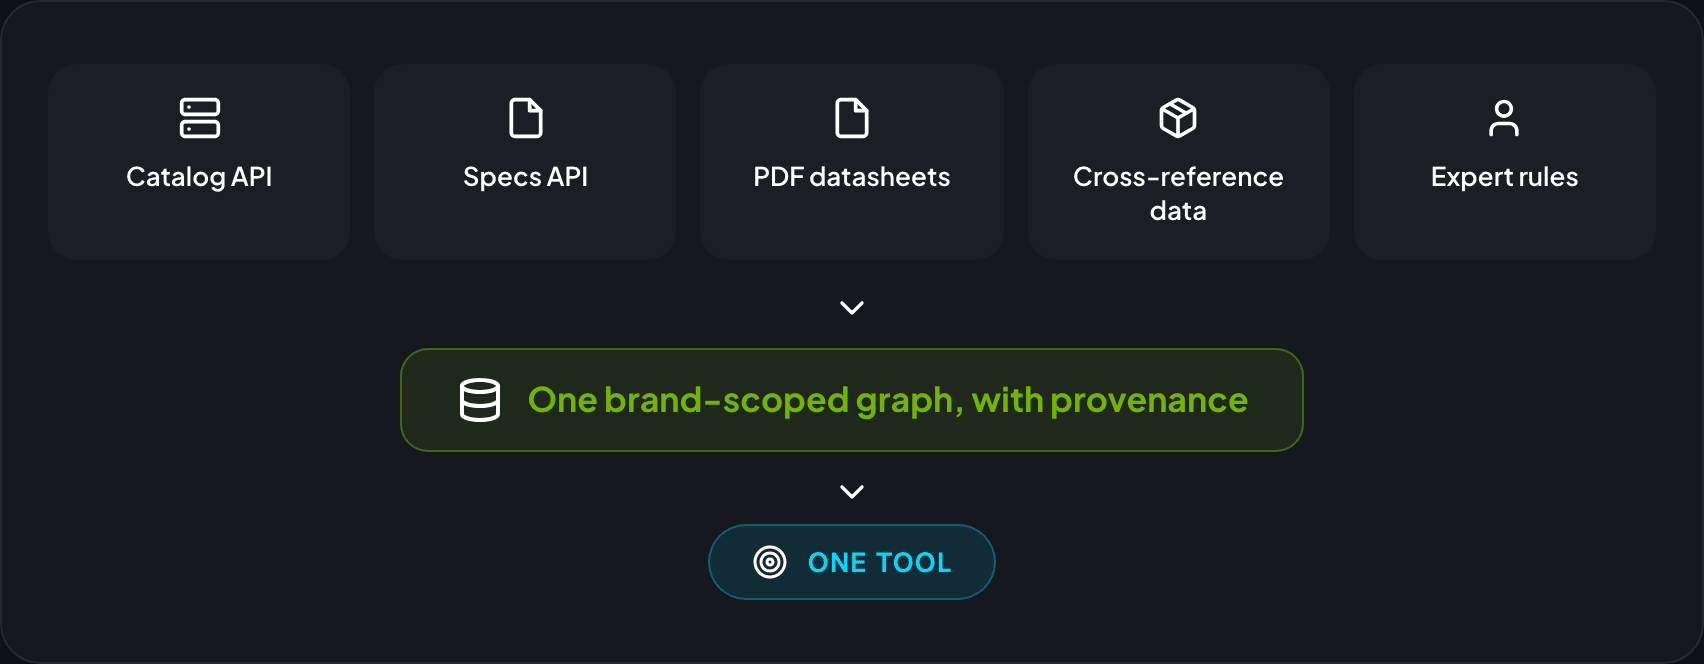
KCS digiere la dificultad para que el agente no tenga que hacerlo. Todo lo difícil del mundo exterior (portales que restringen el acceso automatizado, tablas de especificaciones renderizadas con JavaScript, fallos de PDF por tamaño, paginación, límites de tasa, nombres de campos inconsistentes, fuentes contradictorias) se absorbe una vez, en tiempo de construcción, por la construcción y las personas que la dirigen. Lo que llega al agente es el producto terminado: información precisa, estructurada y verificada sobre la que puede actuar directamente. El trabajo del agente es razonar sobre el problema del cliente.
Eso es KCS: la capa que se come el desorden externo para que el agente reciba una verdad limpia y navegable.
02 · CONSTRUCCIÓN VS CONSULTA
Por qué no consultamos las fuentes en el momento de la pregunta
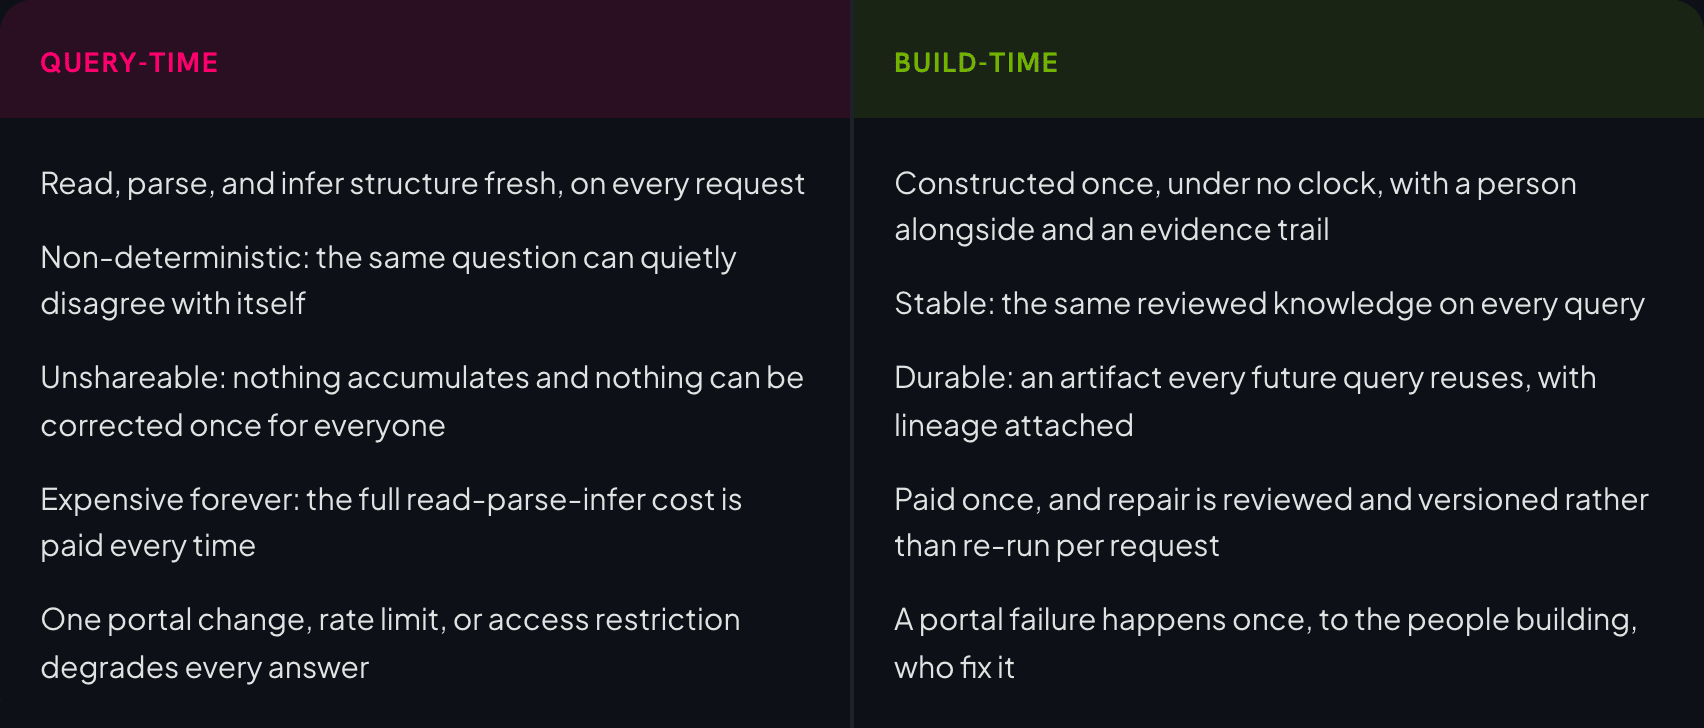
La alternativa obvia a un grafo preconstruido es fundamentar las respuestas leyendo el portal o los documentos de la marca en vivo, en el momento de la consulta. Cuando una marca tiene una buena API, la usamos (ver arriba). Para el conocimiento que vive en páginas, documentos e imágenes, construimos KCS porque la lectura en vivo no se sostiene. Dos clases de fallo, ambas observadas en marcas reales.
Fragilidad
Fundamentar en el momento de la consulta depende de portales de marca que restringen o limitan el acceso automatizado, lo que los convierte en dependencias poco confiables para una consulta de cara al cliente. Un proceso en tiempo de construcción puede espaciar sus solicitudes, pedir a la marca acceso autorizado o trabajar con documentos que la marca ha publicado abiertamente.
Rederivación
Incluso cuando la lectura en vivo funciona, le estás pidiendo al modelo que reconstruya la estructura a partir de texto crudo en cada solicitud: qué campos son especificaciones, qué cadena es el número de pieza, cómo se relaciona este producto con esa familia, qué documento respalda qué afirmación. Ese trabajo requiere inferencia, con tres propiedades que lo hacen poco adecuado para la ruta crítica.
No determinista
La misma página, leída dos veces, no se reduce a la misma estructura dos veces: la recuperación trae fragmentos distintos, el modelo los lee en otro orden, una tabla decodificada queda ligeramente distinta. Dos usuarios que hacen la misma pregunta, o el mismo usuario en dos turnos, pueden recibir respuestas que discrepan en silencio, sin nada en los registros que lo explique. En nuestro índice entre marcas, el 13,2% de las combinaciones de pregunta y modelo obtuvo veredictos distintos en tres preguntas idénticas. El conocimiento nunca estuvo fijo; se volvía a adivinar cada vez.
No compartible
Como la estructura solo existe durante una solicitud, nada se acumula. No hay un artefacto que una segunda consulta pueda reutilizar, ni un lugar donde adjuntar la procedencia, ni una verdad de referencia que una persona pueda revisar y corregir una vez para todos. Cada solicitud empieza de cero y cada solicitud puede equivocarse de una forma nueva.
Caro, para siempre
Pagas el costo completo de leer, procesar e inferir en la solicitud uno, y otra vez en la solicitud un millón. El trabajo es idéntico cada vez y se desecha cada vez.
La construcción en tiempo de construcción elimina los tres. Derivas la estructura una vez, sin reloj, con personas y la auditoría (sección 4) observando; la registras como entidades y relaciones con procedencia; y la congelas. Después, cada consulta lee datos revisados, aislada de lo que el portal devuelva en ese momento. El conocimiento es el mismo cada vez, y cuando está mal lo corriges en un solo lugar en vez de esperar que la próxima tirada de dados salga bien.
Los documentos grandes agravan el problema
Gran parte del conocimiento real de una marca vive en catálogos PDF, y procesar uno en vivo, dentro de un turno de consulta es el peor lugar para hacerlo.
- Es lento y no cabe. No puedes leer, procesar y razonar sobre eso dentro de un turno sin desbordar la ventana de contexto y el presupuesto de latencia. El documento tiene que fragmentarse, y vuelves a una recuperación que encuentra texto que parece relevante (sección 1), sobre la marcha, contra el reloj.
- No es reproducible. La extracción de PDF pierde información y depende del orden: el mismo documento procesado dos veces produce tablas ligeramente distintas, límites de campo distintos, residuos distintos. Así, la misma pregunta sobre el mismo catálogo devuelve una respuesta distinta según qué procesamiento le haya tocado al modelo. Es exactamente el fallo de "no es lo mismo dos veces" con el que abre este artículo, importado directamente al momento de la consulta.
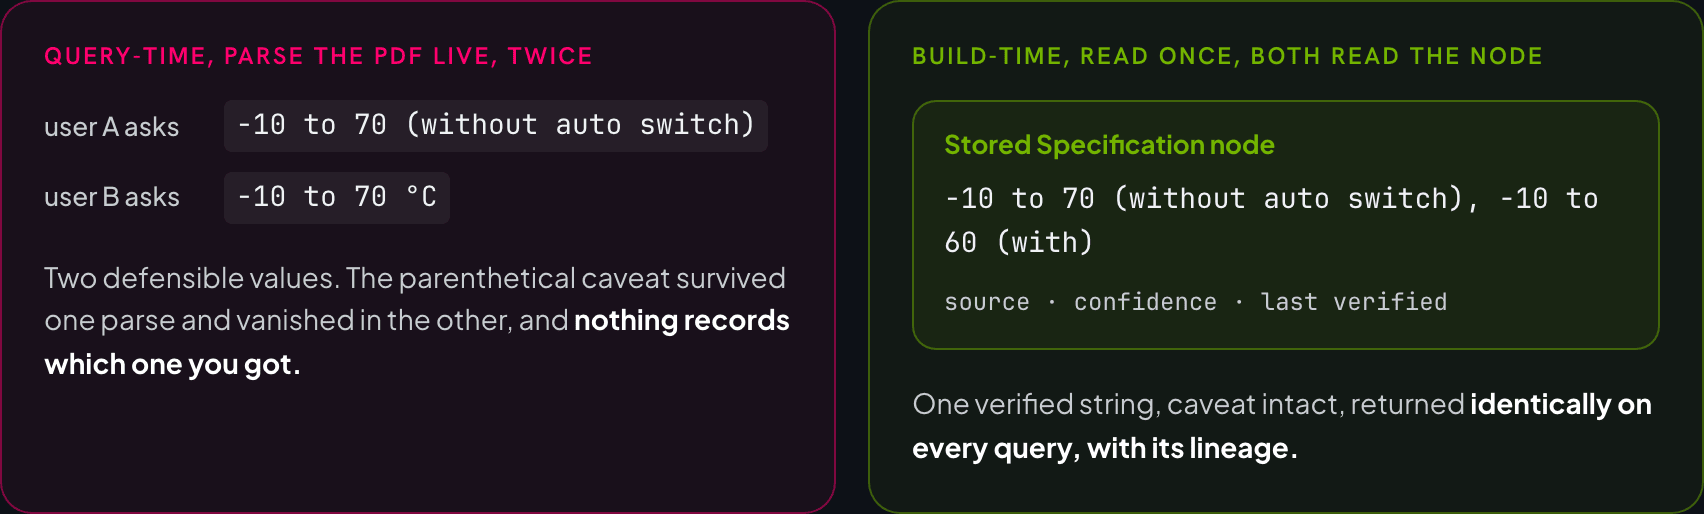
- La calidad es una moneda al aire. Recuerda el valor de la Marca A
Ambient and fluid temperature -10 to 70 (without auto switch), -10 to 60 (with auto switch). Capturar bien ese paréntesis requiere una extracción cuidadosa y verificada. Hecho en vivo y bajo presión, la salvedad es lo primero que se pierde, y una salvedad perdida es una especificación equivocada entregada con total confianza.
El tiempo de construcción invierte los tres: procesa el catálogo de 717 mil caracteres una vez, extrae las especificaciones con cuidado, verifícalas contra la auditoría (sección 4), almacénalas como nodos estructurados con procedencia y congélalas. Cada consulta posterior lee el mismo valor verificado. Sin reprocesar, sin deriva, sin moneda al aire.
03 · CÓMO CONSTRUIMOS
Cómo construimos el grafo
Entonces, constrúyelo una vez, en tiempo de construcción. Pero ¿cómo? Las dos respuestas obvias fallan.
A mano no resiste el contacto con la escala. Nadie va a escribir ese grafo a mano, y nadie va a mantenerlo al día a mano cuando cambie el catálogo.
Un agente sin supervisión falla de otra forma, y peor, porque falla en silencio. Un agente al que se le da un portal y un grafo escribirá con confianza una estructura plausible que está mal de maneras que nadie ve hasta que un cliente recibe una mala respuesta.
Lo que funciona está entre las dos: un agente que hace el trabajo pesado, con una persona a su lado, y evidencia de todo lo que escribe.
Lo que nos enseñó la primera versión
Nuestro primer enfoque dividió la construcción entre varios agentes especializados, cada uno entregando un resumen al siguiente. Nos dio disciplina, pero también fragmentó el contexto. Nadie tenía el panorama completo, y el proceso era difícil de seguir o dirigir para una persona.
La siguiente versión pone a un agente a cargo de la construcción de una marca, con el contexto completo, trabajando junto a una persona. Tres principios se mantienen de la primera versión:
- Las personas siguen en el circuito. El agente explica lo que está haciendo, y una persona puede dirigirlo y aprobar las decisiones que importan.
- Cada hecho tiene linaje. De dónde vino y qué tan seguros estamos.
- El razonamiento ocurre sobre el contenido real. No sobre una receta rígida escrita de antemano.
Cómo construimos depende de lo que ofrece una marca. Donde existe una buena API, el grafo apunta a ella y no la copia. Donde no, construimos el conocimiento a partir de las fuentes que sí existen.
Varios agentes, cada uno pasando un resumen al siguiente. Disciplina, pero nadie tiene el panorama completo.
Un agente, un panorama completo, una persona al lado.
Dos reglas que no flexibilizamos
Cada escritura se queda dentro de una marca. Cada hecho lleva de dónde vino, si fue declarado o inferido y qué tan seguros estamos. Estas reglas existen para detectar corrupción silenciosa. En la Marca D, relaciones válidas se descartaron en silencio durante una construcción. Nada falló, y una persona notó el hueco mucho después, que es la peor forma de enterarse. Cambiamos el sistema para que este tipo de fallo se detecte mientras ocurre la escritura.
La escala también importa
Pasar de una construcción elemento por elemento a una por lotes hizo las construcciones grandes aproximadamente un orden de magnitud más rápidas.
Medido en la construcción completa de una marca.
EL GRAFO EN SÍ
Cómo se ve un grafo de marca terminado
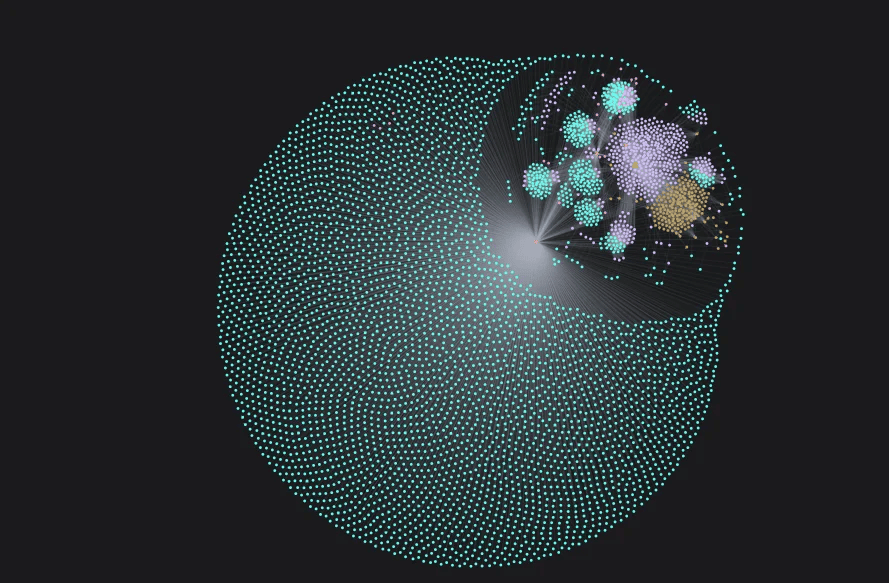
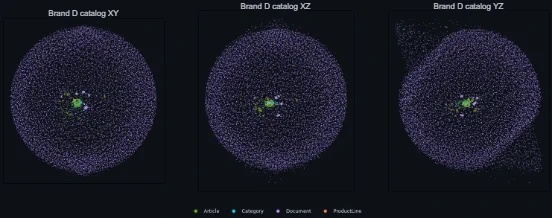
Un grafo duradero es un artefacto que puedes señalar. Este es el grafo de la Marca D tal como está, renderizado a partir de los mismos datos que consulta el agente.
Leerlo en tres dimensiones
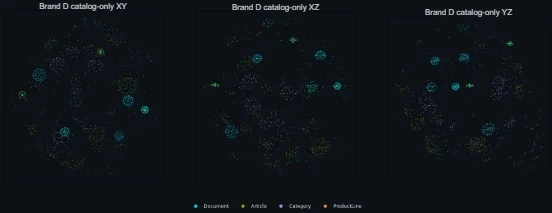
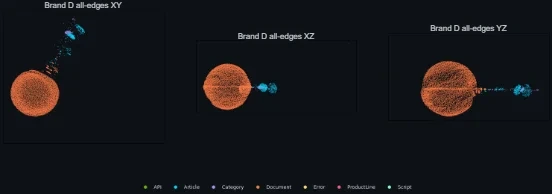
También estamos probando renders 3D de los mismos grafos. Los mismos datos, otro instrumento: la densidad de los clústeres y la forma de una familia de productos se ven mejor cuando el diseño tiene otra dirección hacia donde ir.
04 · LA AUDITORÍA
La construcción vale lo que puedas demostrar
La lección más constante en construcciones reales de marcas es que un grafo que parece terminado puede tener todavía huecos serios. Revisar la primera construcción de la Marca F reveló 24 problemas, y un comentario los resumió:
"Todo se ve en verde, pero los datos están mal."
Esos defectos concretos son historia; el grafo se reconstruyó desde entonces. La pregunta importante es cómo sobrevivieron a una construcción exitosa. Un proceso solo puede informar sobre sí mismo. Cada etapa devolvió éxito y nada en la ejecución discrepó, porque nada en la ejecución estaba fuera de ella.
Así que medimos el mismo grafo otra vez meses después, en una sola instantánea. Cada cifra de esta sección sale de ella.
Los fallos recurrentes adoptan cuatro formas en las distintas marcas:
Un solo valor donde la fuente tenía varios
Un documento que cubría toda una familia de productos se almacenó como si describiera un solo producto. Nada en el valor almacenado indica que fue una elección.
El tipo correcto, el significado equivocado
Un valor es válido y buscable, pero significa algo distinto de lo que pregunta el cliente. Una consulta por rango sobre él recorre en silencio el dato equivocado.
Confianza autodeclarada
El sistema marcó su propia salida como verificada, y no lo estaba. La marca puede ser sincera, pero es una autodeclaración y no una medición.
Una fuente que se degrada en la conversión
El grafo guarda un registro fiel de una lectura con pérdidas, y ninguna verificación dentro del grafo puede detectarlo, porque el grafo nunca vio el original. Las reglas de red de una fuente bloquearon nuestro primer lector, así que lo cambiamos. La versión más difícil de este problema es aquella en la que la lectura funciona, pero la conversión aplana una tabla o pierde una figura.
La procedencia es el instrumento que hace que el grafo sea comprobable. Cada nodo de datos de ese grafo lleva su linaje. Linaje completo, y aun así el dato puede estar mal, que es exactamente para lo que sirve tenerlo. Un valor con un linaje perfecto todavía puede derivarse del lugar equivocado. Ese defecto se encontró con una sola consulta solo porque la evidencia estaba guardada junto al valor.
El verde registra un momento; la confianza duradera exige verificación continua. El informe de construcción de principios de agosto registró cero huérfanos, en un grafo que tenía 2.289 nodos en ese momento. Era cierto. El grafo siguió creciendo de forma incremental durante meses, como lo hace un grafo de marca real, hasta los 2.603 nodos medidos arriba. En esa instantánea posterior, 176 de sus 333 nodos de documento no colgaban de nada: ni producto, ni sección. Algunos eran papeleo corporativo que no pertenecía a ningún lado. Otros eran manuales y catálogos inalcanzables desde cualquier producto por el que preguntaría un cliente. Uno de ellos se titula Ambient Temperature, una fila de especificación que se convirtió en documento.
Una auditoría que se ejecuta una vez es una fotografía de un grafo que ya no existe. Un control que se ejecuta al final de una construcción no puede ver lo que hace la siguiente escritura, así que un defecto registrado en una auditoría puede persistir intacto en mediciones posteriores.
Marca A: una construcción limpia, de principio a fin
Especificaciones extraídas de los PDFs, no inferidas:
Ese último valor, con la salvedad conservada entre paréntesis, es la señal de que la tabla realmente se leyó. La auditoría de la Marca A salió limpia en todas las verificaciones. El mismo proceso, el mismo verde, la verdad opuesta, y la diferencia está por completo en lo que se verificó y no en lo que se informó.
Lo que cuesta un hecho no demostrado
El fallo no es solo una respuesta equivocada. Pregúntale al agente de la Marca F por un producto cuyas potencias nominales nunca llegaron al grafo y hace lo razonable: va y lee el catálogo.
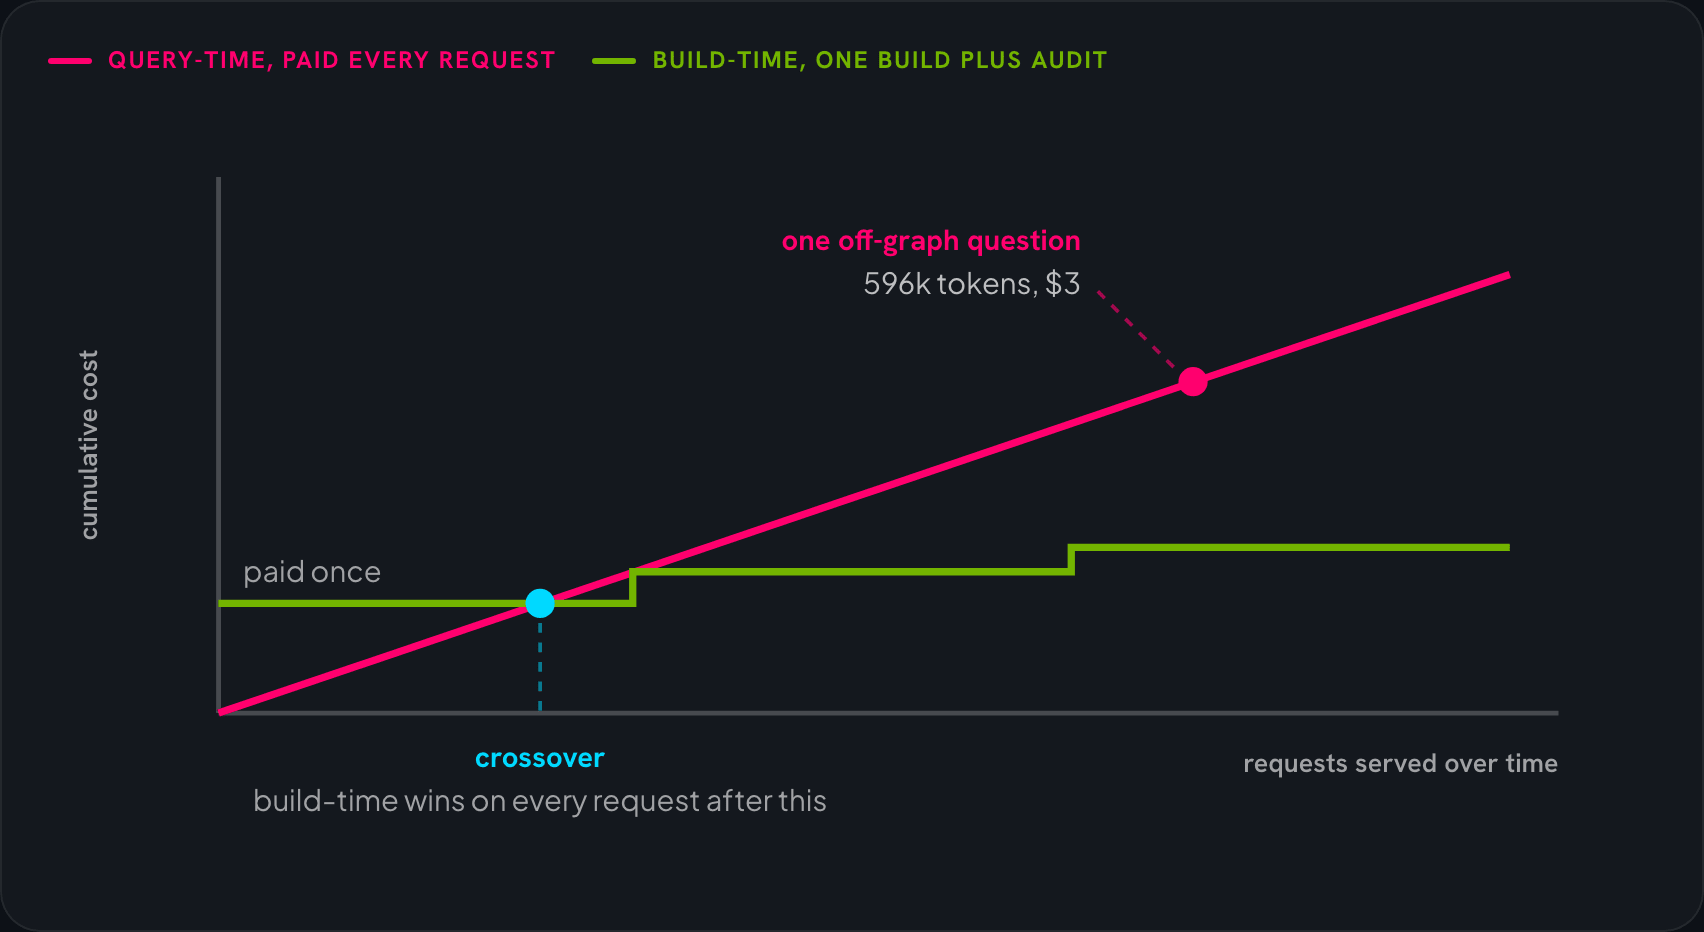
un catálogo puesto en el contexto lleva un turno de 17 mil tokens a 596 mil, y esa ruta de respaldo ha llegado a 3 dólares por una sola pregunta
nadie eligió gastar la diferencia, y ningún panel lo señaló, porque desde fuera el agente parecía funcionar
Un hueco de cobertura que nadie podía ver es una factura que alguien paga por pregunta, y la auditoría es lo que la vuelve a convertir en un costo de ingeniería único. Ninguno de estos defectos hizo fallar una construcción. Se encontraron apuntando un instrumento a un grafo terminado y pidiéndole que se demostrara, una consulta a la vez.
Una construcción está terminada cuando algo externo lo dice, nunca cuando lo dice la propia construcción.
05 · REPARACIÓN
Degradación elegante, para un grafo
La degradación elegante fue el hilo conductor del primer artículo. Un grafo duradero necesita la misma disciplina aplicada a sí mismo: cuando el grafo está mal, la reparación tiene que estar tan bien diseñada como la construcción. Un parche sobre un grafo en vivo agrega un segundo cambio sin revisar encima del primero.
Planificar
Mostrar qué cambiaría antes de que nada cambie
Aplicar
Aplicarlo por la misma ruta controlada que la construcción
Verificar
Comprobar lo que realmente está ahí, no si los totales coinciden
Así que las reparaciones siguen la misma disciplina que la construcción: mostrar qué cambiaría antes de que nada cambie, aplicarlo por la misma ruta controlada y comprobar el resultado por lo que realmente está ahí, no por si los totales coinciden. Totales que coinciden pueden ocultar filas equivocadas. El trabajo en curso permanece invisible para todos los demás hasta que una persona lo aprueba, y lo que se rechaza no deja rastro. Cada versión de un grafo se puede reproducir y, si hace falta, restaurar.
La regla debajo de todo: nada sobrescribe nada sin que se le vea hacerlo.
Estamos simplificando esta ruta para las personas que dirigen una construcción, para que una corrección no necesite su propio proyecto cada vez.
El tiempo de construcción paga la construcción una vez. También tiene que pagar la reparación una vez, revisada, versionada, demostrable, o el segundo pago es por donde se escapa toda la confianza ganada con el primero.
06 · EL ARGUMENTO
Tiempo de construcción frente a tiempo de consulta, el argumento central dicho con claridad
Todo lo anterior es un mismo argumento planteado de cinco maneras. Dicho una vez: para el conocimiento que hay que construir, un agente debería navegar lo que se construyó antes de que llegue la pregunta, manteniendo la construcción fuera del tiempo de espera del usuario. Cuando la propia API de una marca ya responde bien la pregunta, el trabajo del grafo es dirigir hacia ella.
Pon los dos diseños lado a lado. El mismo usuario, la misma pregunta, la misma marca. Lo único que cambia es cuándo se ensambla el conocimiento.
La misma pregunta, hecha dos veces
Una especificación de la Marca A, dos lecturas. Solo un diseño da la misma respuesta las dos veces.
Donde se cruzan los dos diseños
Costo acumulado a medida que se acumulan las solicitudes. El tiempo de construcción paga por adelantado y luego se mantiene plano.
07 · RESULTADOS Y MÉTRICAS
Resultados y métricas
Dos conjuntos de mediciones, y responden preguntas distintas. El primero es un índice entre marcas que publicamos por separado. El segundo es una mirada más cercana a tres grafos de marca.
El índice entre marcas. 100 preguntas redactadas a partir de 14 catálogos de fabricantes, en cinco tipos de consulta, enviadas a tres modelos de frontera, sin herramientas y, cuando el proveedor lo permite, con búsqueda web. Cada pregunta se hizo tres veces. GPT-6 Astra es el modelo de comparación nombrado en todo el texto. Probado en septiembre de 2026.
La búsqueda web elevó las puntuaciones entre tres y cuatro veces, y aun la mejor configuración se quedó corta: GPT-6 Astra con búsqueda acertó 46 de 100 preguntas, 12 parcialmente (contadas como media, para su 52,0%) y falló 42. La búsqueda encuentra páginas. No comprueba que la página esté vigente ni que describa el producto correcto.
Lo que el índice muestra y lo que no. Las respuestas de referencia son las respuestas de ReshapeX, verificadas por nuestros ingenieros contra la documentación de los fabricantes, y fueron correctas en las 100 preguntas. Eso las convierte en la vara de medir, no en un competidor evaluado en igualdad de condiciones. ReshapeX además funcionó con versiones de modelo más antiguas que las evaluadas. Creemos que la capa de conocimiento explica la diferencia, pero el índice no se diseñó para probarlo. La comparación de la Marca B, más abajo, es la versión controlada de esa pregunta. Informe completo: reshapex.com/iaai2026.
Una mirada más cercana a tres marcas
Tres grafos de marca, medidos de la misma forma. El modelo de comparación en todo momento es GPT-6 Astra con búsqueda web activada, probado en septiembre de 2026.
| Medida | Marca A | Marca B | Marca C |
|---|---|---|---|
| Precisión, grafo | 100% | 100% | 100% |
| Precisión, GPT-6 Astra con búsqueda web | 45% estricto / 57,5% flexible | 62,5% | 58% |
| Mismo agente, sin grafo | No disponible | 68,8%, el grafo es la única variable | No disponible |
| Latencia, grafo frente a sin grafo | grafo ~3,6x más lento | grafo ~1,2x más lento, aún más rápido que un modelo de frontera con búsqueda web en la mediana | grafo más lento en la mediana |
| Tiempo de desarrollo, grafo frente a sin grafo | ~2 días frente a ~5 días est. | ~1 semana frente a ~3 semanas, se repite por marca | ~8 días frente a ~8 días |
| Completitud, amplitud | 99,7% de páginas / 83% de productos | 100% de productos | 74,3% de productos / 83,3% de categorías |
| Completitud, profundidad (especificaciones) | 24,6% de las series | 77,1% en total, un subcatálogo en 0% | 68,4% de los productos |
La precisión es el resultado limpio. El agente respaldado por el grafo respondió correctamente en las tres marcas, frente a un 45 a 62,5% de GPT-6 Astra con búsqueda web en esos tres conjuntos de marca. En el índice de 14 catálogos, la mejor configuración de frontera con búsqueda llegó al 52,0%. La Marca B es la lectura más precisa, porque el mismo agente se ejecutó con y sin el grafo y nada más cambió: 100% con él, 68,8% sin él.
La Marca A tiene dos cifras para el modelo de comparación porque dos criterios de evaluación dan dos respuestas distintas. El estricto cuenta una respuesta como correcta solo cuando cada parte es correcta y está respaldada: el número de pieza, el valor de la especificación, la afirmación de disponibilidad y una fuente que realmente lo diga. El flexible también acepta una respuesta que identifica el producto correcto o llega a la conclusión correcta, aunque equivoque un detalle secundario o no lo cite. El agente respaldado por el grafo obtiene 100% con ambos criterios, así que las dos cifras aparecen solo del lado de la comparación, donde la diferencia entre ellas, 45% frente a 57,5%, mide con qué frecuencia el modelo acertó en la dirección y falló en lo específico.
Lee esa precisión junto a la fila de profundidad que está debajo, porque las dos describen cosas distintas y es fácil malinterpretar la combinación. La precisión se mide sobre un conjunto de preguntas, no sobre el catálogo. En la Marca A, el conjunto de preguntas se podía responder con el grafo tal como estaba construido, así que 100% significa que el agente acertó cada vez que se le preguntó por la parte del catálogo que cubre el grafo, mientras que la profundidad de especificaciones dice que esa parte es el 24,6% de las series de la marca. La afirmación es corrección dentro de la cobertura, no la cobertura en sí. La amplitud y la profundidad son lo que el grafo sabe; la precisión es qué tan confiablemente responde a partir de lo que sabe. Las series restantes de una marca deben construirse antes de que siquiera se pueda preguntar por ellas, y por eso las cifras de completitud se quedan en esta tabla junto a las de precisión.
La latencia es el intercambio honesto, y el grafo es la ruta más lenta. Frente al mismo agente sin grafo, la ejecución con grafo es unas 3,6 veces más lenta en la Marca A, unas 1,2 veces más lenta en la Marca B y más lenta en la mediana en la Marca C. El grafo fija el conocimiento, no la salida del agente: el agente sigue razonando y el recorrido sigue costando tiempo. La Marca B es el punto de referencia que vale la pena retener: incluso con 1,2 veces, sigue respondiendo más rápido en la mediana que un modelo de frontera con búsqueda web, porque un recorrido reemplaza un rastreo en vivo.
El tiempo de desarrollo no es una victoria uniforme. La Marca C tardó más o menos lo mismo que la ruta sin grafo, y la Marca F se reconstruyó después de su primera auditoría. Construir un grafo se paga en precisión y reutilización, no en el calendario de la primera construcción.
La completitud sigue siendo desigual. La amplitud, cuánto de la estructura del catálogo de una marca representa el grafo, es alta en las tres, de alrededor del 75% al 100%. La profundidad, las especificaciones, documentos y datos de precios asociados a cada producto, va muy por detrás, y de forma desigual incluso dentro de una marca: la cobertura agregada de especificaciones del 77,1% de la Marca B oculta un subcatálogo concreto en 0%, invisible hasta que miras debajo del promedio. Nada de esto está "terminado". Es la primera evidencia entre marcas de que la apuesta por el grafo duradero da resultado, con los huecos nombrados en vez de ocultos, y el resultado de la Marca C completa ese patrón.
08 · PALABRAS FINALES
Palabras finales
El grafo no eliminó la necesidad de criterio del arnés. Le dio a ese criterio algo sólido en qué apoyarse: una estructura que puede navegar en vez de volver a derivarla desde cero cada vez que cambia la pregunta. El contexto es la arquitectura; el grafo es de donde viene el contexto duradero.
La recompensa aparece cuando la mides. En las tres marcas evaluadas en la sección 7, el agente respaldado por el grafo respondió correctamente los conjuntos de preguntas difíciles el 100% de las veces, mientras que un modelo de frontera con búsqueda web quedó entre el 45 y el 62,5% en esos conjuntos y no pasó del 52,0% en el índice de 14 catálogos, fallando justo en lo que una búsqueda en vivo hace mal: piezas descontinuadas, existencias en vivo y referencias cruzadas entre marcas. En la Marca B, donde el grafo fue la única variable en un agente por lo demás idéntico, la versión sin grafo obtuvo 68,8% frente al 100% de la versión con grafo, lo que atribuye la mejora al grafo y no al arnés que lo rodea. El índice de 14 catálogos no se diseñó para aislar eso; esta comparación sí. Y los grafos detrás de esas ejecuciones tardaron de dos a ocho días cada uno en construirse, sin necesidad de reconstruirlos para alcanzar esas puntuaciones.
Nada de eso es la meta. Un grafo solo vale la pena si lo que se construye encima es confiable y demostrable. El próximo artículo trata de esa capa: cómo los agentes consultan el grafo y cómo medimos, marca por marca, si se gana su lugar frente a un modelo de frontera en el propio catálogo de la marca.
El grafo duradero es la base; lo que construimos encima es donde se entrega el valor.